
Cómo la topología de red importa al diseñar una arquitectura en la nube
Intro
"¿Otra parte más sobre redes? ¿No era que ya empezábamos con AWS?", puede que te estés preguntando.
Sí, mi querido/a lector/a, tenés razón en preguntar eso.
He aquí el punto importante: lo que vamos a ver hoy aplica a cualquier proveedor de la nube, por lo que no tenía sentido cubrirlo para AWS nomás. Es más, hoy voy a cometer herejía y comentarte algunas cosas de GCP (Google Cloud Platform) también (?.
Si en las partes anteriores de esta serie vimos distintos conceptos importantes sobre redes en general, lo que examinaremos hoy es algo fundamental a nivel infraestructura, ya que nos adentraremos en lo que se conoce como "cloud topology" o topología de la nube.
Además, algo importantísimo: los cargos por transferencia o egreso de datos. Porque los datos que los Data Engineers decimos mover mediante los sistemas que construimos tienen que justamente viajar por un medio, y ese medio suele ser las redes de computadora. La nube no es, de ningún modo, la excepción a esto.
Como de costumbre, iremos paso a paso, de manera organizada y con ejemplos didácticos. Porque siempre es más sencillo recordar un concepto cuando lo asociamos con algo cotidiano.
A medida que luego profundicemos en AWS y sus diferentes servicios en este blog, mencionaremos y repasaremos varias de las cosas que veremos acá.
Por último pero no menos importante, la fuente de este artículo es el genial "Fundamentals of Data Engineering", de Joe Reis y Matt Housley.
Cloud Topology
¿Qué se entiende por topología? Podemos iniciar por definir topología de red, que es uno de los conceptos más fundamentales que podemos abarcar cuando hablamos de computadoras:
La topología de red describe la disposición física o lógica de los nodos y las conexiones en una red de ordenadores (como estrella, anillo o malla)
Aplicado a la nube, la "cloud topology" describe cómo varios componentes en la nube están organizados y conectados, como servicios, redes, ubicaciones (zonas, regiones) y más.
Como Ingenieros de Datos es muy importante entender cómo la topología de la nube afectará la conectividad entre los sistemas de datos que construyamos.
Los tres grandes proveedores de la nube, es decir, Microsoft Azure, Google Cloud Platform (GCP) y Amazon Web Services (AWS) utilizan una jerarquía de recursos bastante similar, basada en zonas de disponibilidad (Availability Zones, abreviado como AZ) y regiones. Hay un detalle adicional con GCP, pero eso lo vamos a cubrir brevemente más abajo.
Para entender esta jerarquía de la que hablamos, vayamos de menor a mayor.
Availability Zones (AZs)
Una availability zone o zona de disponibilidad es la unidad más pequeña de topología de red que los proveedores de la nube pública hacen visibles para sus clientes.
Cada una de estas zonas puede consistir potencialmente de múltiples data centers, cada uno con su propia energía, sistema de enfriamiento y red.
Estos data centers, o centros de datos, hospedan los servidores, dispositivos de almacenamiento y equipo de redes que potencian los servicios de estos proveedores, gestionando, procesando y almacenando de manera segura vastas cantidades de datos. Por eso se dice que la nube no es otra cosa que "la compu de alguien más".
Cada AZ es un centro autónomo dentro de una región, que ofrece redundancia y alta disponibilidad. Esto es importante de entender, ya que es la base del concepto de resiliencia. En otras palabras, esta configuración asegura que si un centro de datos experimenta algún tipo de problema, otros pueden tomar su lugar y mantener la continuidad en los servicios.
Si bien una AZ puede potencialmente consistir de múltiples centros de datos, los clientes no pueden controlar la ubicación de los recursos a este nivel. Es decir, si desplegamos una máquina virtual (VM) en una AZ determinada, no podemos determinar en qué centro de datos, ni mucho menos en qué máquina física, correrá nuestra VM.
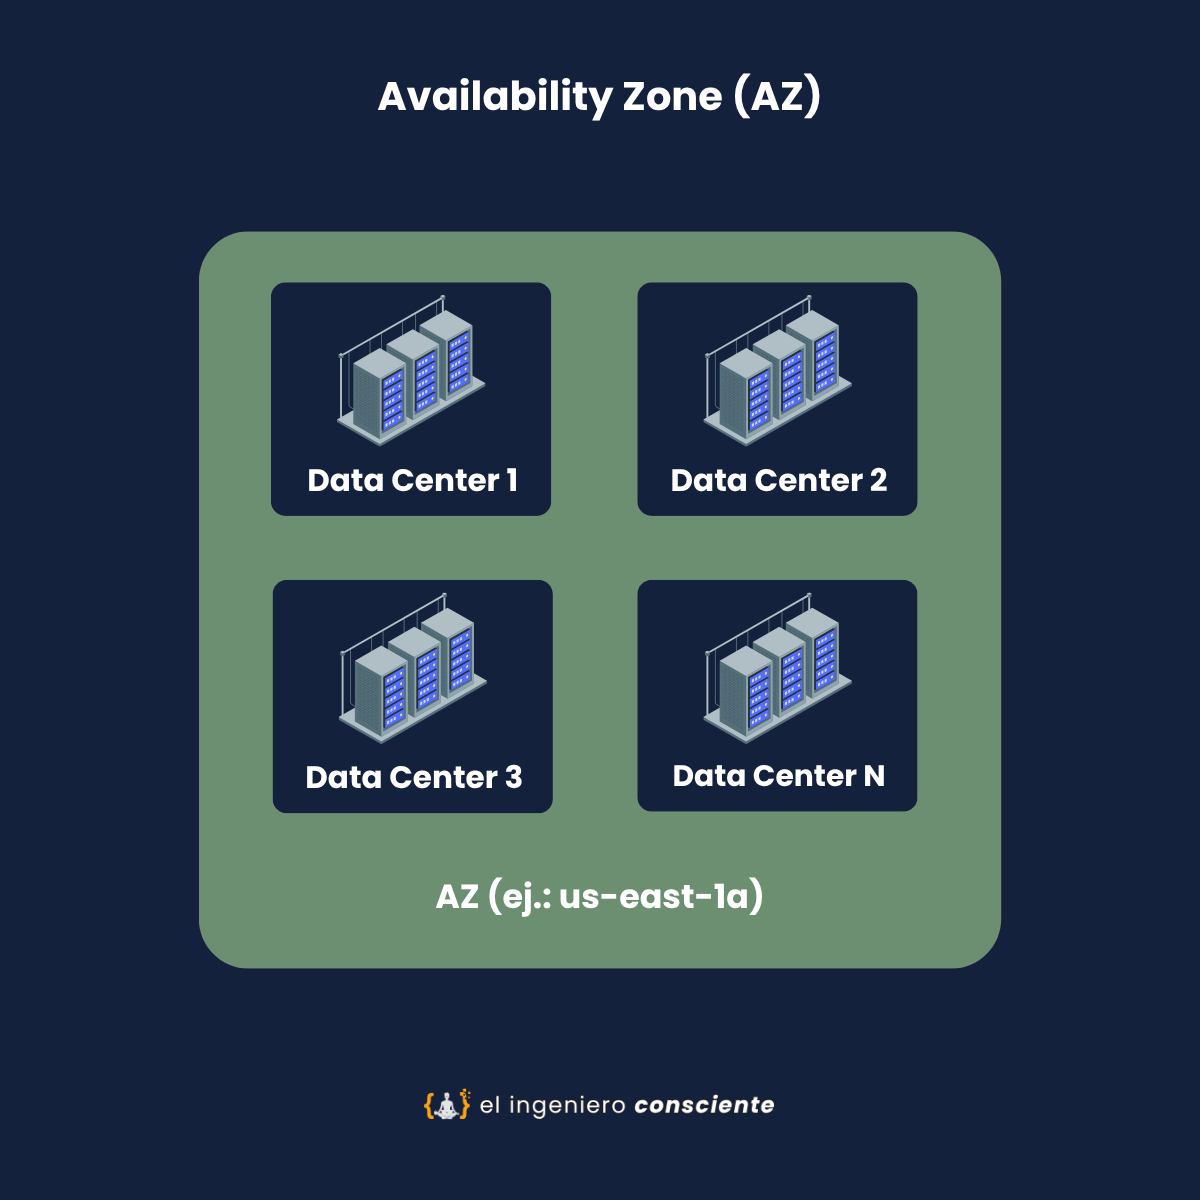
Generalmente los proveedores ofrecen su mayor ancho de banda y su más baja latencia entre sistemas y servicios ubicados dentro de una misma AZ. Si te ponés a pensar, tiene sentido. A fin de cuentas, estos sistemas y servicios corren en data centers relativamente cerca uno del otro.
Es por este motivo que, por ejemplo, un proceso que requiera alto rendimiento con respecto a la transferencia de datos se va a beneficiar más de estar ubicado en una sola AZ, por cuestiones de costos y eficiencia.
Regiones
Una región es una colección de 2 o más AZs. Para construir un sistema de alta resiliencia, podemos desplegar infraestructura en una región, y luego separar recursos, como servidores, en múltiples AZs, o crear un plan donde un servidor configurado en una AZ entre en acción en el momento en el que nuestro servidor principal, configurado en otra AZ, experimente algún fallo. Esto es lo que se conoce como failover, o conmutación por error.
Al contar con diferentes regiones, podemos desplegar recursos lo más cerca posible de los usuarios de dichos recursos. Con "cerca" estamos hablando de que los usuarios puedan contar con un buen rendimiento en términos de red/conexión, ya que estamos minimizando la distancia física que deberían recorrer los datos que viajan a través de dicha red/conexión, y minimizando los "saltos" o hops que deben realizar los datos entre distintos routers. En serio, hay que estudiar networking.
Tanto la distancia física como los hops pueden incrementar la latencia y reducir la eficiencia. Es por eso que los proveedores principales de la nube pública siguen agregando más regiones.
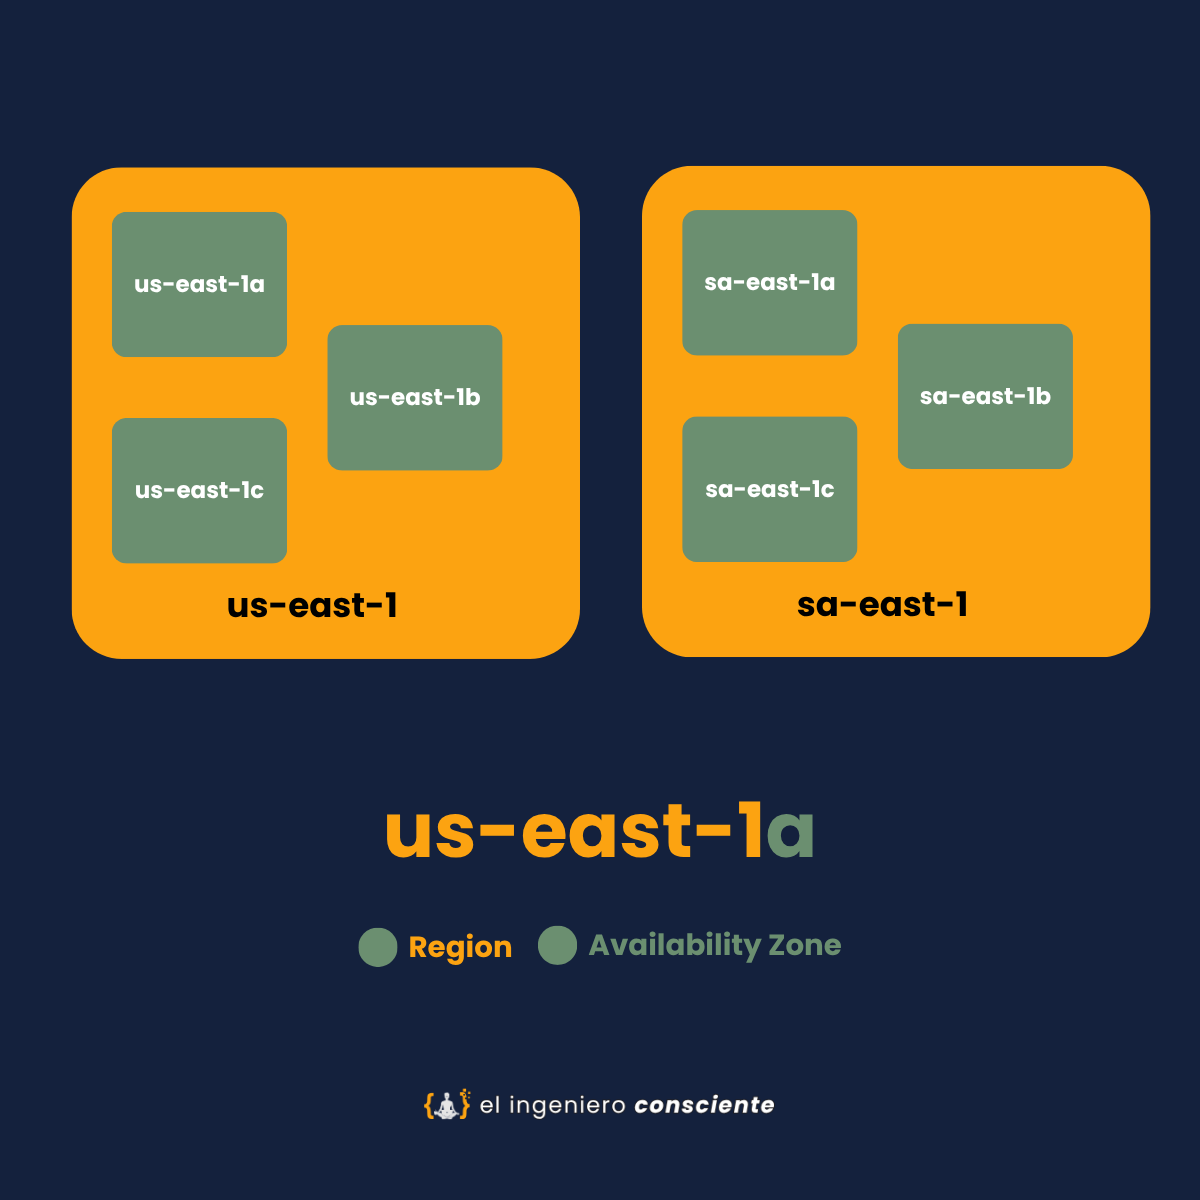
En general, las regiones soportan una conexión de red rápida y de baja latencia entre AZs. Claro, el rendimiento de red entre AZs será peor que el que ocurre dentro de una misma AZ, como vimos anteriormente.
En el caso de AWS, y a fecha de publicación de este artículo, este proveedor se extiende a través de 39 regiones geográficas alrededor del mundo. Cada región es una parte clave de su arquitectura global. Con más de 550 puntos de presencia, AWS asegura que sus servicios sean accesibles a nivel mundial.
Más allá de las regiones y AZs, AWS extiende su alcance a nivel global a través de lo que se conoce como Edge Locations, siendo estas alrededor de 400 en todo el planeta.
Estas Edge Locations son el lugar donde AWS almacena en caché datos cerca de sus usuarios finales, reduciendo la latencia y aumentando la velocidad de acceso a los mismos.
Veremos esto más de cerca cuando nos toque hablar de servicios como CloudFront y Lambda@Edge.
El concepto multiregión de GCP
Dudé en incluir esto en este post, pero si te pareces a mí, estoy seguro de que te gusta saber de todo un poco.
Aunque está claro que lo que escribo está la mayor parte del tiempo enfocado en AWS, nunca está demás aprender una que otra cosita de los demás proveedores. A fin de cuentas, no conviene realmente "casarse" con ninguno.
GCP ofrece un puñado de abstracciones bastante únicas que hay tener presente si nos toca trabajar con este proveedor. La más importante es el concepto de multiregión, una capa dentro de la jerarquía de recursos que estamos abarcando. Como su nombre lo indica, una multiregión contiene múltiples regiones. Ningún misterio ahí.
Las multiregiones actuales comprenden los Estados Unidos (centros de datos en este país), UE (centros de datos en los países miembro de la Unión Europea) y Asia.
Muchos recursos de GCP ofrecen soporte multiregión, como Cloud Storage o BigQuery. Los datos son almacenados de manera geo-redundante en múltiples AZs dentro de la multiregión. De este modo, si una región experimenta problemas, los datos permanecen disponibles en otra región.
El almacenamiento multiregión en GCP está diseñado también para entregar datos eficientemente a los usuarios dentro de dicha multiregión sin que haya que desplegar un proceso de replicación entre regiones, lo cual suele ser complejo.
Esto en AWS o Azure es distinto. Podemos construir infraestructura multiregión, sí, pero para el caso de bases de datos o almacenamiento de objetos, debemos duplicar los datos entre regiones para aumentar la redundancia y acercar los datos a los usuarios.
Además, Google posee más recursos de redes a nivel global que los otros proveedores, algo que ofrecen a sus clientes como networking de clase premium. Este tipo de networking permite que el tráfico entre AZs y regiones pase enteramente por las redes propietarias de Google sin atravesar en ningún momento la internet pública.
Cargos de transferencia de datos
Todo muy lindo con las AZs, las regiones, la redundancia, la eficiencia y todo eso. Pero ahora toca hablar de plata. Porque ni AWS ni GCP ni Azure ofrecen sus servicios por amor al arte, eso está claro.
Como dijimos al principio, los sistemas que construimos mueven datos. Hay datos viajando de punto A a punto B, y cuando entra en juego la topología de la nube, tenemos que hablar sobre el precio a pagar para que estos datos viajen por la red, sumado al precio que haya que pagar por la base de datos, el almacenamiento de objetos o la máquina virtual que utilicemos.
Comencemos por lo esencial: los proveedores permiten tráfico entrante hacia nuestros recursos desplegados (como una máquina virtual) de manera gratuita, pero cobran por el tráfico saliente hacia la internet. El tráfico de salida no es intrínsecamente más barato, pero los proveedores usan este método para que a los clientes (lo que nos incluye) les resulte más difícil irse con la competencia, ya que esto aumenta la retención de los datos almacenados. Esta es una práctica que ha sido ampliamente criticada.
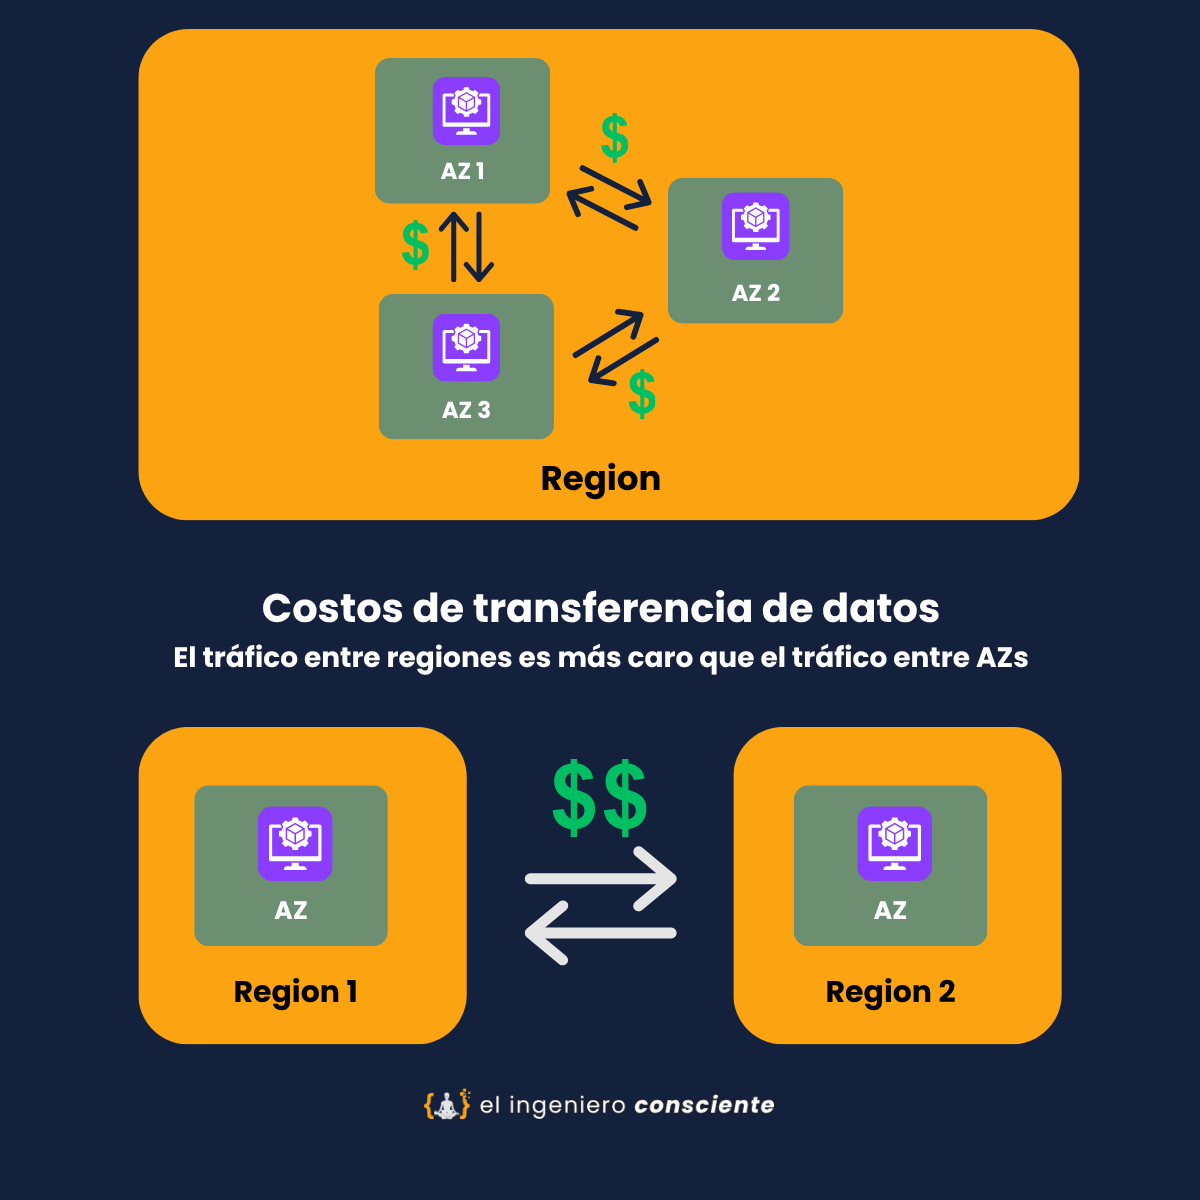
Algo más a tener presente son los costos de transferencia de datos entre AZs y regiones. Esto significa que si el tráfico tiene que pasar de una AZ a otra, habrá costos a pagar, y lo mismo aplica si ese tráfico sale de una región y tiene que ir hacia otra. Ojo que el tráfico entre regiones es más caro que el tráfico entre AZs.
¿Qué ocurre con la transferencia de datos que se realiza entre dos recursos que están en una misma AZ? Bueno, he aquí la buena noticia: es gratis. Pero no es tan sencillo. Por ejemplo, para las máquina virtuales, el tráfico tiene que ser enviado a una IP privada. Los proveedores utilizan redes virtuales conocidas como nubes privadas virtuales, o más conocidas por sus siglas en inglés: VPC (Virtual Private Clouds).
Las VMs pueden tener IPs privadas dentro del contexto de la VPC. También se les puede asignar IPs públicas para comunicarse con el mundo exterior y recibir tráfico desde internet, pero las comunicaciones que involucran direcciones IP externas pueden incurrir en costos de egreso de datos. De nuevo, hay que estudiar networking.
Con respecto al almacenamiento de objetos, como por ejemplo S3, es bueno tener presente que este que es un recurso regional. Puede que algunos datos tengan que viajar entre AZs para alcanzar una máquina virtual, pero no existen costos de red directos por esto, más allá de los costos de acceso a los datos almacenados, claro. Por ejemplo, si nuestra VM desplegada en Amazon EC2 se encuentra en la misma región que nuestro bucket en Amazon S3, el tráfico entre EC2 y S3 es gratuito. Solo pagamos lo que cuesta cada servicio, pero no por la transferencia de datos.
Conexiones Directas a la Nube
Cada proveedor grande de la nube pública ofrece opciones de conectividad mejorada, permitiendo a sus clientes integrar sus redes, es decir, sus conexiones on-premise, con una región de la nube o de manera directa con una VPC. Por ejemplo, AWS ofrece Direct Connect como una de estas soluciones.
He aquí lo importante: además de proveer un ancho de banda mayor y mejor latencia, estas opciones de conectividad ofrecen descuentos dramáticos con respecto a costos de transferencia de datos. En un escenario típico en Estados Unidos, los costos en AWS bajan de 9 centavos por gigabyte transmitido por la internet a 2 centavos por gigabyte transmitido a través de Direct Connect.
Sobre el futuro de los cargos de transferencia de datos
Esta es una apreciación hecha por Joe Reis, uno de los autores del "Fundamentals of Data Engineering", que me pareció super interesante de compartir.
Por un lado, Reis reconoce que los costos de transferencia de datos son un impedimento significativo con respecto a interoperabilidad, intercambio de datos, y movimientos de los mismos hacia la nube. Como vimos anteriormente, es una estrategia para generar una "barrera competitiva" y dificultar a los clientes abandonar una nube en particular o desplegar en nubes distintas.
Pero existen algunas señales interesantes que indican que hay un cambio en el horizonte. Algo que resultó impactante, allá por el 2020 al comienzo de la pandemia, fue el anuncio de Zoom donde indicaban que habían elegido a Oracle como su proveedor de la nube.
¿Cómo fue que Oracle se ganó a Zoom, que resultó ser una pieza fundamental del trabajo remoto en esa época? El experto en AWS Corey Quinn ofrece una respuesta directa y a la vez razonable. Según sus cálculos, los cargos de transferencia de datos de Zoom habrían pasado los 11 millones de dólares si hubieran elegido a AWS, mientras que los costos en Oracle se ubicarían por debajo de los 2 millones.
Reis entonces sospecha que GCP, AWS o Azure anunciarán recortes significativos en los costos de transferencia de datos en los próximos años, provocando así un cambio muy importante en el modelo de negocio de la nube. Incluso puede que estos cargos desaparezcan por completo, muy parecido a como ocurrió con las llamadas celulares, donde hace décadas que ya no se cobra por minutos para llamadas.
Unas palabritas sobre CDNs
Último concepto que veremos hoy: las content delivery networks (CDN) o redes de entrega de contenido, que ofrecen mejoras de rendimiento dramáticas como así tambien grandes descuentos al momento de entregar activos de datos al público o a clientes.
Los proveedores ofrecen varias opciones de CDN, como por ejemplo CloudFront en AWS. Estas CDNs funcionan mejor cuando hay que entregar los mismos datos en repetidas oportunidades. El truco es que los datos frecuentes se guardan en una caché que está ubicada muy cerca del usuario que va a consumir esos datos. Esto mejora el rendimiento, disminuye la latencia y evita que el servidor que contiene los datos se sature con peticiones.
Por más lindo que suene, hay que prestar atención igual. Las CDNs no funcionan en todas partes y algunos países incluso bloquean entrega de contenido mediante CDNs.
Resumen
A lo largo de este artículo exploramos cómo los proveedores de la nube organizan su infraestructura física a nivel global para ofrecer servicios rápidos, resilientes y disponibles en cualquier parte del mundo. Repasemos los puntos clave:
- Regiones: son ubicaciones geográficas independientes donde los proveedores de nube despliegan su infraestructura. Elegir la región correcta impacta directamente en la latencia, el cumplimiento normativo y los costos.
- Availability Zones (AZs): dentro de cada región, existen múltiples AZs que son centros de datos físicamente separados pero interconectados. Esto permite diseñar arquitecturas tolerantes a fallos, ya que si una AZ falla, las demás siguen operando.
- Costos de transferencia de datos: analizamos cómo estos costos pueden acumularse silenciosamente en arquitecturas mal diseñadas, y trajimos a la mesa la perspectiva de Joe Reis, quien advierte que este modelo de cobro por transferencia de datos —diseñado en gran parte para "atrapar" a los usuarios dentro de un mismo proveedor— probablemente enfrente cada vez más presión y escrutinio a futuro, conforme las organizaciones busquen mayor libertad y portabilidad en sus arquitecturas multi-cloud.
- CDNs (Content Delivery Networks): cerramos hablando de cómo estas redes distribuyen contenido más cerca del usuario final, reduciendo la latencia y mejorando la experiencia general.
En conjunto, estos conceptos forman la columna vertebral de cualquier arquitectura en la nube moderna.
Sin entender regiones y AZs, es difícil diseñar sistemas verdaderamente resilientes y escalables. Y no tener presente a los costos de transferencia de datos es lo que suele traer sorpresas en la factura.
Conclusión
Y un día hemos llegado al final. Se terminó "Cloud Computing Fundamentals". Si leíste cada post, dejame transmitirte un enorme y sincero "¡Gracias!". Abarcar todos los conceptos que vimos en cada publicación fue un esfuerzo de búsqueda, investigación, organización y más.
Todos los temas que vimos a lo largo de toda esta serie ahora forman parte de nuestra cajita de herramientas, componen la guía básica y esencial para poder ir a fondo con el proveedor que forma uno de los pilares de "El Ingeniero Consciente": Amazon Web Services.
Es momento de entrar a fondo, y para ser sincero, me emociona por fin poder comenzar con una nueva serie de blog posts, que es algo así como iniciar un viaje nuevo.
En "AWS Fundamentals", el nombre con el que decidí bautizar la serie que se viene, vamos a ver:
- Qué es realmente AWS, una breve historia de sus inicios y cómo dar los primeros pasos
- Vamos a analizar muchos servicios esenciales, con IAM y CloudWatch a la cabeza, seguido por pesos pesados como EC2, Lambda, S3, SNS, SQS y más!
- Y para cada servicio explicado, vamos a abordar sus características clave, conceptos esenciales, costos, trade-offs y todo lo que nos permita utilizaro con eficiencia y seguridad en mente
Nos vemos en el próximo artículo. 🚀